
isaac lab arenaを活用した模倣学習の評価
こんにちは。Muso Action の 渡辺です。
Muso Action では、物流現場の作業をロボットに任せるために、人のデモンストレーションから動作を学ぶ「模倣学習」に取り組んでいます。アームに取り付けたカメラの映像から次の動作を予測する policy を学習して、実機で動かす、というのが日々の仕事です。
この記事は、そのうち モデルの「評価」 の話です。
結論を先に書くと、NVIDIA の Isaac Lab Arena を評価基盤に据えたことで、それまで実機でやるしかなかった評価を効率化できました。
模倣学習の評価を、毎回実機でやるのがつらかった
模倣学習(ロボットの行動学習)の policy は、学習中の lossの値だけでは、そのPolicyが良いものかを分かりません。正しく言うと、lossが下がらなければ悪いモデルだということは分かっても、下がったからといって良いモデルであるとは限りません。これはロボットの行動学習はマルコフ過程で徐々に誤差が蓄積していくためです。そのため、損失が下がっている checkpoint のうちどれが良いかは、実際に動かしてタスクが成功したかどうかを数えるしかないというのが実感です。
そうすると評価は実機で回すことになりますが、これがとにかく重くなります。
- 実機と作業スペースを占有する。 評価している間は、ロボットも場所も他のことに使えません。
- 初期条件を揃えられない。 対象物の位置や向きを、人手で毎回ミリ単位に戻すのは無理です。条件が違えば、成功率の差が policy の差なのか置き方の差なのか分からなくなります。
- 照明が日によって、時間によって変わる。 窓から入る光も、周りの設備が落とす影も、こちらでは選べません。
- 試行回数が稼げない。 1 本あたり数十秒かかるので、1 条件 数10回も回せば半日が溶けます。
模倣学習では モデル自体の改善をしたりハイパーパラメータのチューニングをしたり、画像の前処理や行動の表現を変えたりして精度を詰めていきますが、候補が 数10 本あっても、実機では全部は試せません。 結果として「たぶんこれが良さそう」で選ぶことになり、選択の根拠が薄くなっていきます。評価が律速となりモデル自体の試行錯誤をすべてできないことが多いです。
Isaac Lab Arena を評価基盤に据えた
そこで、評価を物理シミュレータの中に持ち込むことにしました。使っているのが Isaac Lab Arena です。
数ある物理シミュレーターの中からisaacを選定してのは、模倣学習で重要になってくるフォトリアリスティックに画像を取得可能である点、GPUで複数のロボットの並行実行が可能な点、また豊富なアセットを活用できるため、選定しました。
isaacの使い方としては、Isaac Lab Arenaは、模倣学習の評価に適していると考えました。
Isaac Lab Arena は NVIDIA が公開しているオープンソースのフレームワークで、公式ドキュメントでは次のように説明されています。
an open-source framework for scalable benchmark authoring and robot policy evaluation in simulation
「シミュレーションでロボット policy を評価するためのベンチマークを作る」 ことがそのまま目的に据えられている、というのが選んだ理由です。ベンチマークそのものではなく、ベンチマークを書くための足場だ、という立ち位置がはっきりしています。
公式ドキュメントのトップページには、このソフトスタックを表した図が載っています。下から順に、物理ソルバ(PhysX / Newton)、それを使うシミュレーションフレームワークの Isaac Lab、それを拡張するポリシー評価フレームワークの Isaac Lab-Arena、そして一番上が Your benchmarks — 利用者が書くベンチマークです。
中身を自分たちのもので埋めると、こうなります。
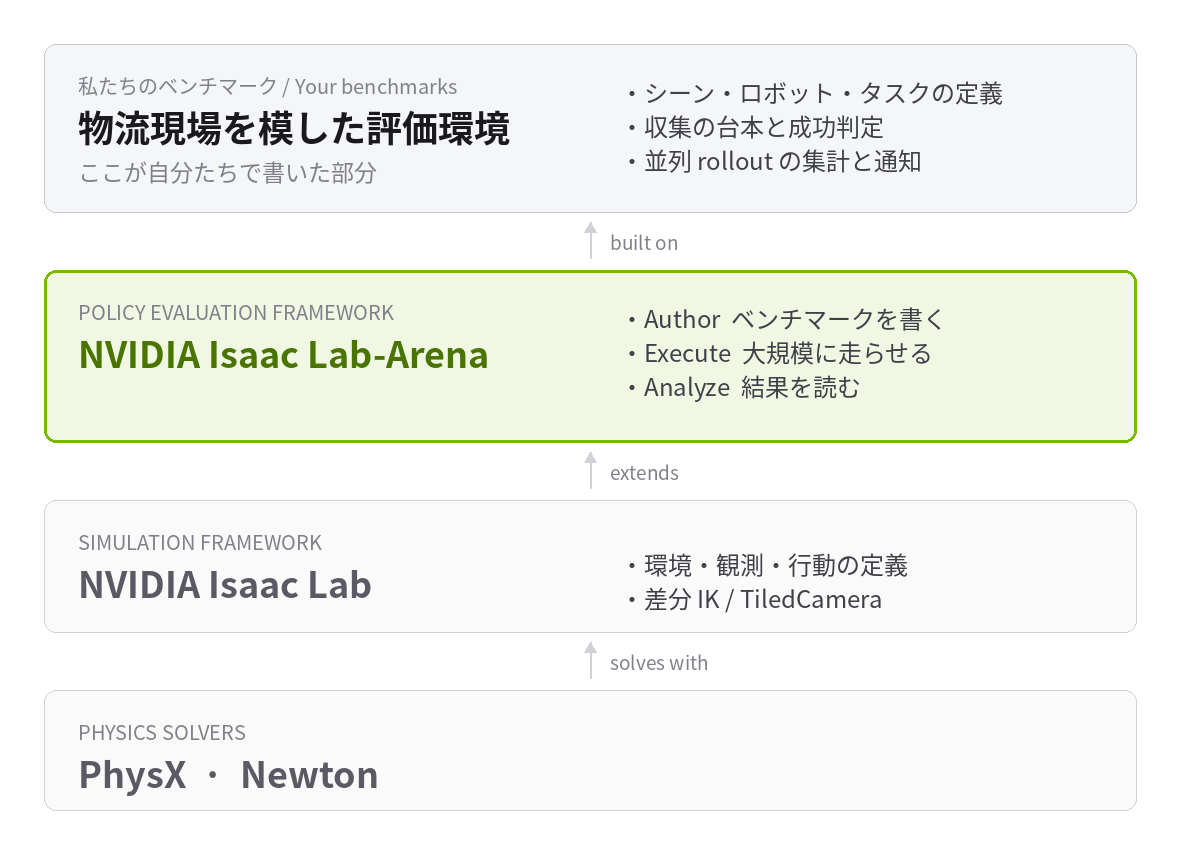
Isaac Lab Arena 公式ドキュメントのスタック図(2026 年 9 月時点)の構成と用語に沿って、最上段の Your benchmarks を私たちの中身に置き換えて作成しました。実際に動かす土台は Isaac Sim です。
ありがたいのは、環境が部品として分かれていることです。シーン(棚や什器)、エンボディメント(ロボットとグリッパ)、タスク(何をどこへ)、ポリシーが、それぞれ独立して差し替えられるように設計されています。おかげで、現場を模した棚のシーンと自分たちのロボットを登録するだけで、評価環境として動き出しました。
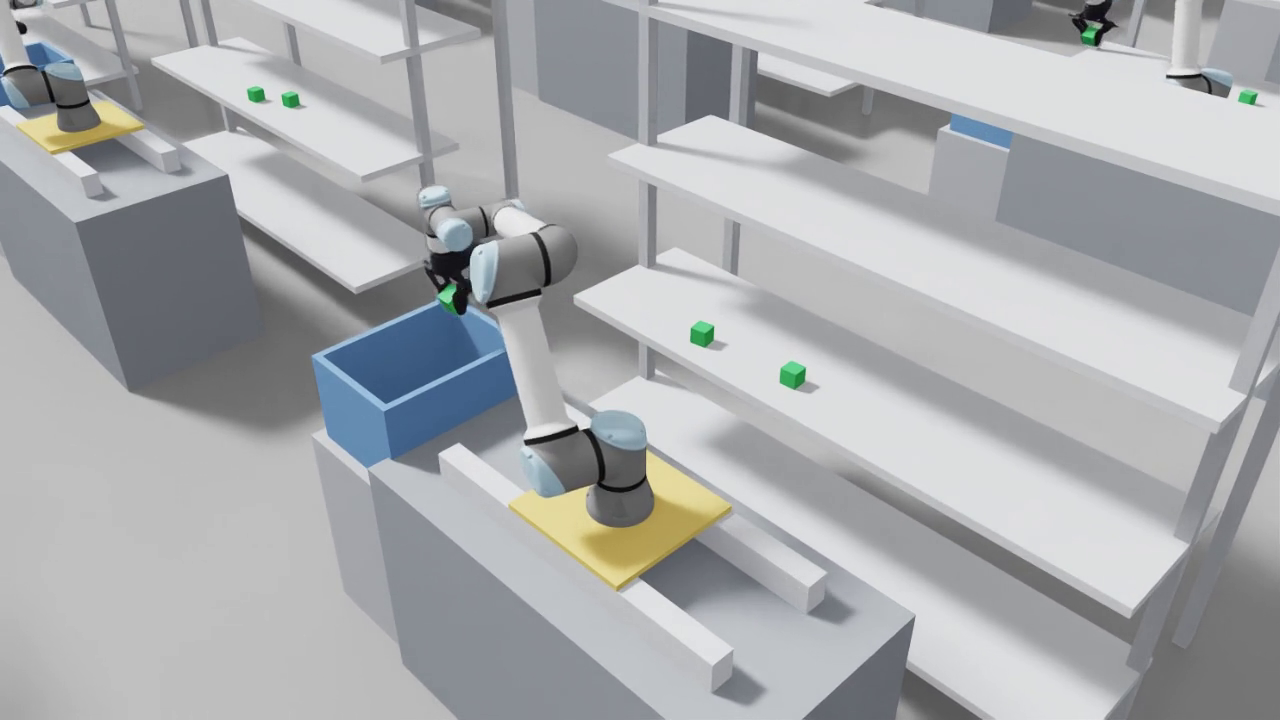
自分たちのシーン・ロボット・タスクを Arena のレジストリに登録する形で拡張しているだけで、追加のコード数もコンパクトに収まっています。
回しているループはこうです。
- シミュレータの中でデータを収集する。 手本の動作に沿って手先のポーズ目標を出し、Isaac Lab の差分 IK が関節指令に変換します。記録は LeRobot のデータセット形式です。
- 学習する。 lerobotで集めたデータセットを、実機と共通の学習基盤で実行します。
- シミュレータで評価する。 学習済みの checkpoint を Arena の環境に戻して、クローズドループで回します。マルコフ過程による時間経過によるズレによる、タスクの失敗/成功も再現することができます。
この 3 段はひとつのパイプラインになっていて、タスク名と実行名を指定すれば端から端まで流れます。
嬉しさ①:照明を変えるだけで、Vision のロバスト性が見える
シミュレータにして一番良かったのが、照明条件を自由に変えられることです。
実機では、照明を変えるのは現実的ではありませんでした。現場の照明は消せないし、時間帯も選べない。「暗いときに弱いのではないか」「日が傾いて影の向きが変わったら崩れるのではないか」と思っても、確かめる手段がなかった。
シミュレータの中なら、照明は設定ひとつで切り替わります。 ロボットのデータ収集も、物理も、成功判定も一切触らずに、policy が見る画だけが変わる。まずは単純に、明るさだけを変えてみます。
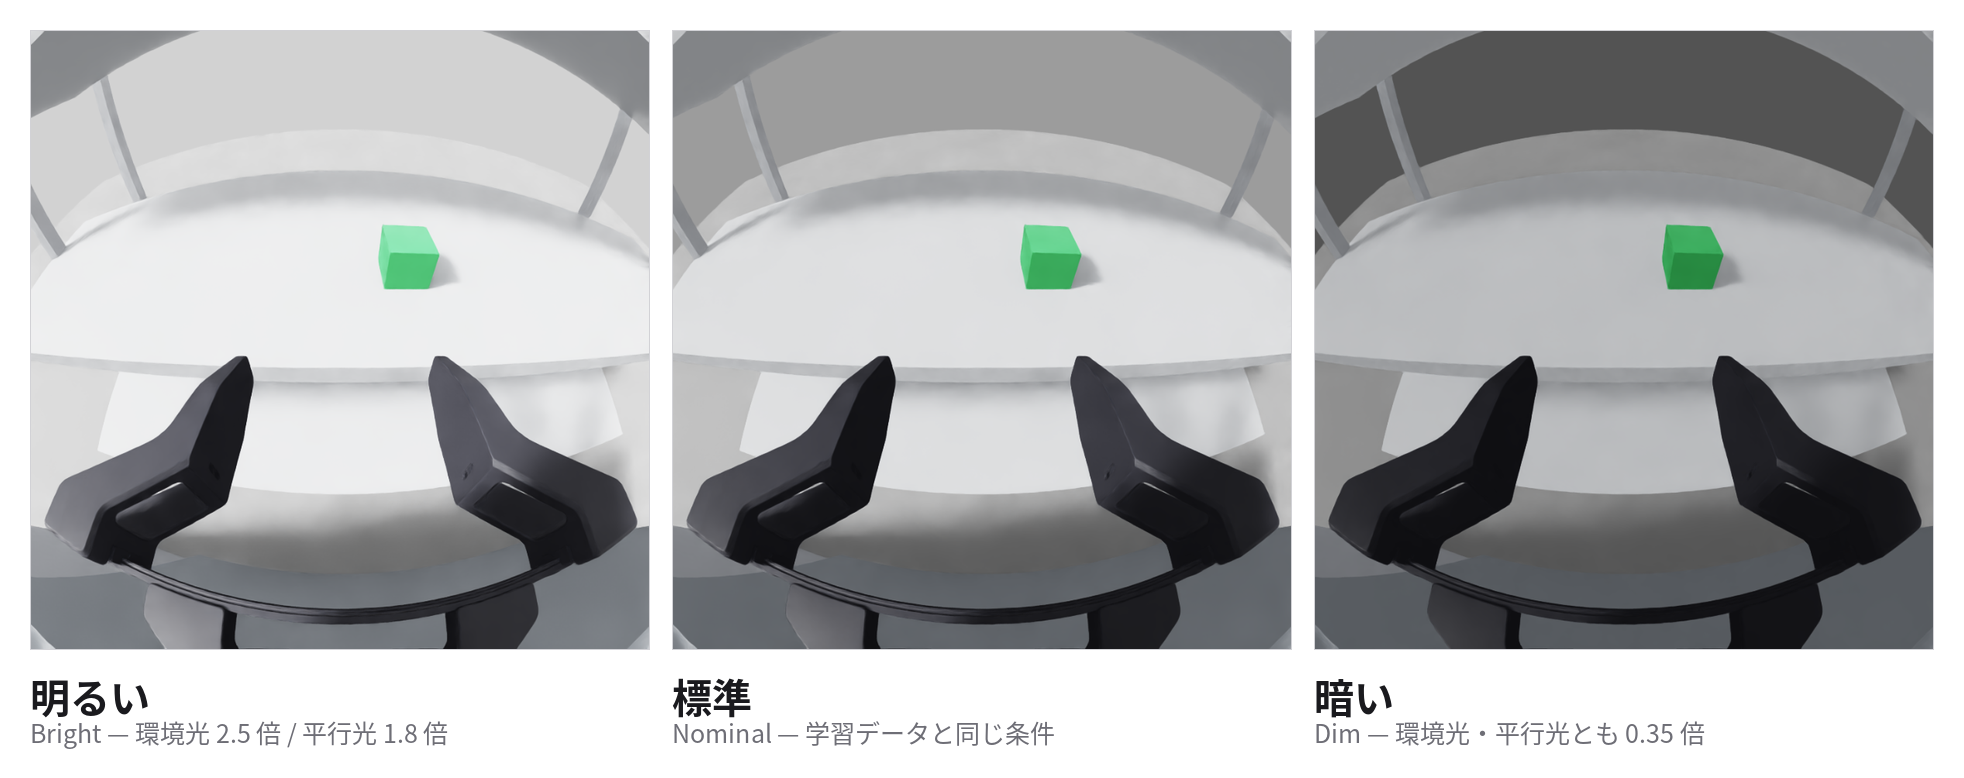
標準は学習データと同じ条件で、明るい・暗いはどちらも学習時に一度も見ていない条件です。手首カメラの平均輝度で 180 / 155 / 120 と、素直に明るさだけが動いています。
明るさのほかに、明るさは変えずに光の向きだけを変える条件も用意しています。影の向きが変わるので、「暗くて見えないから失敗した」のか 「陰影の手がかりが変わったときに崩れた」 のかを切り分けられます。
これを回してみると、実機では見えていなかったことが出てきました。傾向として分かったことの例をご紹介します。
- 標準照明では横並びに見える backbone どうしが、光の向きを変えた途端に順位が入れ替わる。 学習データと同じ条件だけで比べていると、どれも同じくらい良く見えてしまって選ぶ材料になりません。分布の外に出して、はじめて差が開きます。
- 同じ backbone でも、行動の表現を変えると照明への強さが変わる。 関節角を直接予測させる構成は、手先ポーズを予測させる構成よりも、光の向きの変化に弱いという傾向が複数のタスクで同じ向きに出ました。backbone も学習データも同じで、違うのは行動表現だけです。視覚の使われ方が行動表現によって変わっている、と読めます。
下は、同じ policy・同じ初期条件のまま照明だけを変えたときの、policy が実際に入力として受け取っている手首カメラの映像です。左が標準照明、右が暗い条件です。
変えたのは明るさだけです。それでもこの policy は掴みにいく位置を外して、キューブを落とします。
俯瞰で見ると、同じエピソードが成功と失敗に分かれているのが分かります。
大事なのは、これらが全部、実機を 1 秒も止めずに分かったことです。実機に持っていく前に弱い候補を落とせるようになり、実機評価は「残った 1〜2 本を確かめる」ためだけに使えるようになりました。
嬉しさ②:ロボットを同時並列に動かして、評価を一気に回す
もうひとつが並列です。
実機は 1 台しかないので、評価は 1 本ずつ順番にやるしかありません。シミュレータなら、同じ policy を多数の環境で同時に走らせられます。 GPU 1 枚の上に環境を並べて、一斉にステップさせる。Arena の公式ドキュメントでも、逐次的な rollout ではなく多数の環境を同時に回して評価を速くすることが、狙いとして明記されています。
冒頭に貼ったのがその様子です。並べたセルがそれぞれ独立に初期化されていて、同じ policy が同時に動いています。棚のシーンだけでなく、コンベアを流れる荷物を扱うタスクも同じ仕組みで並列に回せます。
並列にして良かったのは、速くなったこと自体よりも、比較が成立するようになったことです。
エピソードごとに乱数のシードを固定しているので、条件を変えても同じ初期状態の集合を評価できます。
明るい条件のエピソードがたまたま簡単な物体ばかりだったら、照明ごとの成功率を並べても、効いていたのが照明なのか物体なのか分かりません。実機で 30 本回すときに起きていたのは、まさにこれでした。シミュレータでシードを固定するというのは、この交絡を最初から作らないということです。
運用としては、評価が終わると Slack に結果が飛んでくるようにしています。成功率と、成功/失敗それぞれの俯瞰カメラと手首カメラの動画。夜のうちに条件をまとめて投げておけば、朝には全部揃っています。失敗動画がその場で見られるので、「そもそも対象物に届いていない」のか「掴めているのに落としている」のかが数字を見る前に分かるのも助かっています。
結果として、backbone の選定やハイパーパラメータの絞り込みを、実機を止めずに回せるようになりました。 「候補が 10 本あっても全部は試せない」という最初の詰まりが、素直に解けた形です。
やってみて分かった、シミュレータで評価するときのコツ
2 つだけ書いておきます。
1. 照明は、設定値を変えたら一度レンダリングして目で見る。 光源の強度を 0.35 倍にしても、画の明るさが 0.35 倍になるわけではありません。トーンマッピングも環境光の回り込みもあるので、設定値と見た目は比例しない。振りすぎると「照明への頑健性の評価」ではなく「真っ暗で何も写らないから失敗」になってしまいます。評価を回す前に、policy が実際に入力として受け取る手首カメラの画を並べて確認するようにしました。上に載せた 4 枚組が、まさにそのための図です。
2. シミュレータの成功率は、実機の成功率ではない。 当たり前ですが大事なところで、順位付けと足切りに使い、最終判断は実機でやると決めています。しかし、シミュレーションである程度、良い精度のポリシーが絞り込めているので、実機の評価が大幅に減らせて楽になりました。
おわりに
模倣学習は「学習」の話が注目されがちですが、実際に回してみると 律速になるのは評価のほうでと考えてます。
Isaac Lab Arena を評価基盤に据えたことで、照明を振って Vision の頑健性を見られるようになり、多数の環境を並列に回して条件を一気に比べられるようになりました。実機評価は、最後の確認に集中させられています。何より、「試せないから決められない」が「試せるから決められる」に変わったのが大きい。
シミュレータで模倣学習の評価をしたい方の参考になれば嬉しいです。
参考リンク
- Isaac Lab Arena — ドキュメント / GitHub
- Isaac Lab — シミュレーションフレームワーク
- Isaac Sim — 物理とレンダリング
- LeRobot — データセット形式と学習まわり
We Are Hiring!
Muso Action では、ロボティクス・機械学習のエンジニアを募集しています。実機とシミュレータの両方を触りながら、現場で動くロボットを作ることに興味のある方は、ぜひ 採用ページ からお声がけください。
カジュアルにお話しするだけでも歓迎です。